Le fichier robots.txt est souvent traité comme un détail technique. En réalité, il influence directement la façon dont Google explore votre site, priorise vos pages et comprend votre structure.
Le vrai enjeu n’est pas de bloquer plus, mais de contrôler mieux. Un robots.txt mal configuré peut réduire la visibilité, retarder l’indexation et créer des pertes de trafic sur des pages commerciales importantes.
Réponse rapide : à quoi sert vraiment le fichier robots.txt ?
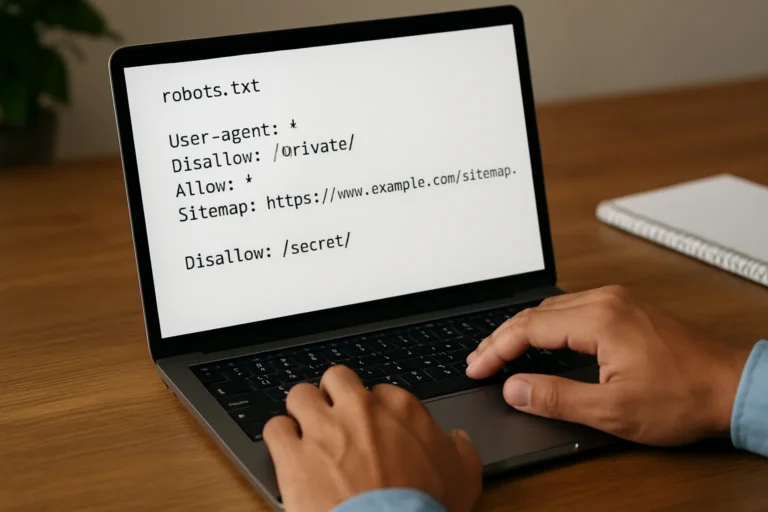
Le fichier robots.txt indique aux robots des moteurs de recherche quelles zones du site ils peuvent explorer ou non. Il ne supprime pas une page de Google à lui seul, mais il peut empêcher son exploration et compliquer son indexation si la page dépend d’un crawl régulier.
En pratique, il sert à protéger les zones inutiles pour le SEO, à économiser le budget de crawl et à orienter les robots vers les pages qui comptent pour la visibilité et la conversion.
Sommaire
Quel est le rôle du fichier robots.txt dans une stratégie SEO ?
Le robots.txt agit comme un panneau de signalisation pour les robots. Il ne remplace pas une stratégie SEO, mais il aide à organiser l’exploration du site de manière plus efficace.
Pour une entreprise, cela compte parce qu’un site bien exploré est plus simple à comprendre pour Google. Les pages stratégiques sont découvertes plus rapidement, les ressources sont mieux utilisées et les pages secondaires ne prennent pas inutilement la place des pages qui génèrent du business.
Sur un site e-commerce, un site institutionnel ou un site B2B, cette logique est essentielle pour structurer visibilite credibilite demandes sans gaspiller le budget de crawl sur des filtres, des paramètres ou des zones techniques.
Quelles pages faut-il bloquer, et lesquelles doivent rester accessibles ?
Le bon arbitrage dépend du rôle de chaque section du site. Il ne s’agit pas de bloquer le maximum, mais de protéger ce qui n’a pas de valeur SEO et de laisser explorer ce qui soutient la performance commerciale.
| Type de page | Action recommandée | Impact business |
|---|---|---|
| Pages d’administration | Bloquer l’exploration | Protège la sécurité et évite le bruit inutile |
| Pages de test ou de préproduction | Bloquer | Évite l’indexation accidentelle |
| Filtres, paramètres, facettes | Bloquer selon le cas | Réduit la dilution du crawl |
| Pages de service importantes | Laisser accessible | Préserve la visibilité et les conversions |
| Pages de contenu stratégique | Laisser accessible | Soutient le trafic qualifié et la génération de leads |
Un site qui doit catalogue entreprise industrielle structurer, par exemple, ne peut pas se permettre de bloquer par erreur les catégories ou les fiches qui servent à capter la demande. Même logique pour un site qui doit qualifiees renforcer credibilite dequipements : les pages qui rassurent et prouvent l’expertise doivent rester visibles.
Quelles erreurs de robots.txt bloquent la visibilité sans qu’on s’en rende compte ?
La plupart des problèmes viennent d’une règle trop large ou d’une mauvaise logique de dossier. Une simple ligne mal placée peut empêcher Google d’explorer des pages clés.
Les erreurs les plus fréquentes
- Bloquer tout le site par accident avec une règle trop large.
- Empêcher l’exploration de dossiers qui contiennent des pages commerciales.
- Confondre blocage d’exploration et suppression d’indexation.
- Oublier qu’un fichier CSS ou JavaScript peut être utile au rendu des pages.
- Ne pas adapter le fichier après une refonte, une migration ou un changement d’arborescence.
Le risque n’est pas seulement technique. Si Google ne peut pas explorer correctement les pages importantes, il comprend moins bien leur contenu, leur hiérarchie et leur valeur. Cela peut ralentir la croissance organique et réduire les opportunités de conversion.
Comment configurer le robots.txt sans bloquer les pages importantes ?
La bonne méthode consiste à partir de la structure réelle du site, pas d’un modèle générique. Chaque règle doit répondre à un besoin précis.
Étape 1 : identifier les zones utiles et inutiles
Commencez par distinguer les pages qui doivent être explorées de celles qui n’apportent aucune valeur SEO. Cela inclut souvent les pages d’administration, les environnements de test, certains paramètres d’URL et les fichiers techniques.
Étape 2 : protéger sans surbloquer
Évitez les règles globales qui touchent des dossiers entiers si une partie du contenu doit rester visible. Une mauvaise granularité peut bloquer des pages qui soutiennent la conversion ou la génération de leads.
Étape 3 : tester avant mise en production
Un robots.txt doit être testé avant publication. Une validation rapide permet de vérifier que les pages stratégiques restent accessibles et que les robots ne sont pas envoyés vers une impasse.
Étape 4 : surveiller après modification
Après un changement, contrôlez les logs, la Search Console et l’évolution de l’indexation. Un fichier robots.txt n’est jamais un élément figé. Il doit évoluer avec le site, la refonte et les objectifs SEO.
Quel impact sur le SEO, le GEO et l’AEO ?
Le robots.txt influence surtout l’exploration, mais cette exploration conditionne ensuite la qualité du référencement global. Si Google explore mieux, il comprend mieux le site, ce qui soutient le classement et la visibilité.
Pour le GEO et l’AEO, la logique est similaire : une structure claire aide les moteurs et les systèmes d’IA à trouver rapidement les pages utiles, à distinguer les contenus prioritaires et à extraire des réponses fiables.
Un site bien organisé facilite aussi la création de contenus qui peuvent être cités ou résumés par les moteurs génératifs. C’est particulièrement utile pour une entreprise qui veut fluidifier echanges gagner efficacite ou améliorer sa présence sur des requêtes à forte intention commerciale.
Chez THE ROAD, l’objectif n’est pas seulement de créer un site web visuellement propre. L’objectif est de construire une présence digitale claire, rapide, crédible et capable de soutenir la croissance de l’entreprise.
Pourquoi ce fichier a un impact direct sur la performance de l’entreprise ?
Un robots.txt bien géré améliore la qualité du crawl, ce qui aide les moteurs à consacrer leurs ressources aux pages qui comptent. Cela se traduit par une meilleure maîtrise de la visibilité et une plus grande cohérence entre contenu, structure et intention de recherche.
Pour une société exportatrice, par exemple, le bon paramétrage peut soutenir international linternational societe exportatrice en évitant que des pages secondaires perturbent l’exploration des pages marchés, produits ou services. Pour une entreprise touristique, il peut aussi aider à mieux organiser touristique tunisie attirer reservations autour des pages qui convertissent réellement.
Le sujet est donc stratégique. Une erreur de configuration peut coûter du trafic, ralentir l’indexation et diminuer la crédibilité perçue par un prospect qui arrive sur un site incomplet ou mal structuré.
Quand faut-il faire appel à une agence web ou à un consultant SEO ?
Dès qu’un site contient plusieurs sections, des filtres, une boutique, des sous-domaines ou une refonte en cours, le robots.txt doit être traité avec méthode. Une simple correction peut éviter des pertes de visibilité difficiles à détecter ensuite.
Une agence sérieuse ne se contente pas d’écrire quelques lignes. Elle vérifie l’arborescence, les objectifs business, les pages prioritaires, les contraintes techniques et les effets sur l’indexation. C’est aussi ce qui permet de renforcer la crédibilité d’un site aux yeux de Google et des utilisateurs.
Si votre site doit améliorer productivite dentreprise lacces ou soutenir des parcours de conversion plus fluides, le fichier robots.txt doit être pensé avec le reste de l’architecture SEO, pas isolément.
FAQ
Le robots.txt peut-il empêcher une page d’être indexée ?
Oui, indirectement. Il peut empêcher l’exploration d’une page, ce qui complique son indexation si Google ne peut pas la lire correctement. En revanche, il ne supprime pas à lui seul une page déjà indexée.
Faut-il bloquer les pages en noindex dans le robots.txt ?
Non, pas systématiquement. Si Google ne peut pas explorer la page, il ne peut pas toujours voir la balise noindex. Le bon choix dépend du cas technique et de l’objectif SEO.
Le fichier robots.txt suffit-il pour protéger des pages sensibles ?
Non. Il ne remplace pas une vraie protection d’accès. Pour des pages confidentielles, il faut une authentification, des restrictions serveur ou d’autres mesures de sécurité adaptées.
Peut-on bloquer les fichiers CSS et JavaScript ?
En général, non. Google a besoin de ces fichiers pour comprendre le rendu réel de la page. Les bloquer peut nuire à l’analyse du site et à la qualité du référencement.
À quelle fréquence faut-il vérifier le robots.txt ?
À chaque refonte, migration, ajout de section ou changement SEO important. Un contrôle régulier évite les blocages accidentels et protège les pages qui génèrent du trafic et des leads.
Faire du robots.txt un outil de pilotage, pas un risque caché
Le fichier robots.txt n’est pas un détail technique secondaire. Bien utilisé, il aide à orienter les robots vers les pages utiles, à préserver le budget de crawl et à renforcer la performance SEO du site.
Mal utilisé, il peut bloquer des pages essentielles, ralentir l’indexation et fragiliser la visibilité commerciale. La bonne approche consiste à le relier à la structure du site, aux objectifs business et au plan de contenu.
Vous avez un projet web, une refonte ou un besoin SEO ? THE ROAD peut vous accompagner avec une approche claire, professionnelle et orientée résultats.